In der KI-Infoecke vor meinem Büro hängen vier Poster – gut sichtbar sowohl für das Kollegium als auch für die Schülerinnen und Schüler der Oberstufe. Auf jedem Poster sind die Ergebnisse einer Studie zusammengefasst, die sich mit Lernen unter KI-Bedingungen befasst und von der ich denke, dass die Schulgemeinschaft sie kennen sollte. Klar ist: Jede Studie ist aus einem anderen Land, mit einem anderen Design, aus einer anderen Forschungslogik heraus entstanden – und mit jeweils ganz eigenen Limitierungen. Die Poster habe ich vor allem deshalb gestaltet, weil ich Kolleginnen und Kollegen etwas an die Hand geben wollte, das sich in zehn Minuten Pause erfassen lässt. Und natürlich auch, weil ich selbst sortieren musste, was da eigentlich gerade passiert – ein Poster ist da ähnlich hilfreich wie ein Blogbeitrag…

Bei aller Freude über die entstehende Übersicht und die klar sichtbaren Implikationen wurde mir zugleich etwas unwohl: Denn mehrere Studienposter nebeneinander an einer Infowand, das mache ich auch gerne in Fortbildungen, erzeugen einen Eindruck von Gesamtevidenz, den keine der Studien jeweils für sich hergibt. Im Schulsystem könnte daraus evtl. sogar ein „Jetzt wissen wir es!“ entstehen. Genau davor möchte ich in diesem Beitrag warnen, und zugleich beschreiben, was sich meiner Ansicht nach eben doch an ersten Konturen abzeichnet.
Sehr dankbar bin ich für die Unterstützung von Dr. Benedikt Wisniewski, der sich sofort bereit erklärt hat, meine Einordnungen mit kurzen Videokommentaren aus seiner wissenschaftlichen Perspektive zu ergänzen. Benedikt ist promovierter Schulpsychologe, Supervisor und Coach. Er war lange als Lehrer und in der Lehrerbildung tätig und forschte zum Thema Feedback an der Universität Augsburg. Als Fachbuchautor und in seinem Podcast „Psychologie fürs Klassenzimmer“ beschäftigt er sich mit psychologischen Themen im Kontext Schule, moderiert aber auch gemeinsam mit Hendrik Haverkamp den Podcast „Kompass KI“, der aktuelle KI-Forschungsergebnisse für Lehrkräfte aufbereitet.
Vier Studien rund um Lernen und KI – China, Türkei und USA
Studie 1: The Generative AI Learning Penalty: Evidence from Chinese Secondary Education
Die erste Studie, Strömberg, Lei und Wu (2026), wertet 30 Monate Paneldaten von 26.811 Schülerinnen und Schülern der Klassen 7 bis 12 in einem Landkreis in Zentralchina aus. Über diesen Zeitraum stieg die selbstberichtete KI-Nutzung von nahezu null auf rund 80 Prozent. Das Ergebnis, das die Autoren „Learning Penalty“ nennen: Die Hausaufgabenleistung steigt um 18 Prozent, die Bearbeitungszeit sinkt um 30 Prozent, und in den monatlichen Klausuren ohne KI brechen die Leistungen um 20 Prozent ein. Bei den Abschlussprüfungen zeigt sich der volle Effekt erst nach etwa zwei Jahren. Die Autoren führen das auf ein Nutzungsmuster zurück, das sie „Homework Outsourcing“ nennen: sehr kurze Bearbeitungszeit bei gleichzeitig sehr guten Hausaufgabennoten, dann aber schwache Klausurergebnisse.
Kommentar von Benedikt Wisniewski zur Studie
Infoposter zur Studie
Studie 2: Generative AI Without Guardrails Can Harm Learning: Evidence from High School Mathematics
Die zweite Studie, Bastani et al. (2025), ist ein randomisiertes Feldexperiment mit knapp 1.000 Schülerinnen und Schülern der Klassen 9 bis 11 in der Türkei, veröffentlicht in PNAS. Drei Gruppen übten Mathematik: ohne KI, mit freiem GPT-4-Zugang und mit einem gemeinsam mit Lehrkräften entwickelten Tutor, der Hinweise statt Lösungen gibt. Die Übungsleistung stieg in beiden KI-Gruppen deutlich, beim Hinweis-Tutor sogar am stärksten. In der anschließenden Prüfung ohne KI schnitt aber nur die Gruppe mit freiem Zugang signifikant schlechter ab als die Kontrollgruppe. Beim Tutor mit Leitplanken verschwand dieser Effekt.
Kommentar von Benedikt Wisniewski zur Studie
Infoposter zur Studie
Studie 3: One Click Away: AI Tutoring with Khanmigo in a Two-Year School Experiment
Die dritte Studie, Oreopoulos et al. (2026), ist ein Feldexperiment mit über 6.000 Schülerinnen und Schülern der Klassen 6 bis 8 in Tennessee. Untersucht wurde unter anderem eine „Mastery“-Regel, bei der drei richtige Antworten in Folge nötig sind, bevor es weitergeht. Diese Regel erhöhte die Zahl derer, die solche Erfolgsserien erreichten, um 28,7 Prozentpunkte. Auf den Test eine Woche später hatte sie praktisch keinen Effekt. Der KI-Tutor wiederum verlangsamte das Üben, half aber dabei, nach Fehlern häufiger richtig weiterzumachen. Ein kleiner Lerneffekt zeigte sich nur in der Kombination beider Elemente, und auch der war nur knapp signifikant.
Kommentar von Benedikt Wisniewski zur Studie
Infoposter zur Studie
Hintergrund-Studie 4: AI tutoring outperforms in-class active learning: an RCT introducing a novel research-based design in an authentic educational setting
Die vierte Studie, Kestin et al. (2025), weist in eine andere Richtung als die ersten drei. Sie erschien in Scientific Reports und untersucht 194 Studierende in Harvards großem Einführungskurs Physik im Herbst 2023. Das Design ist ein randomisiertes Crossover: Dieselben Studierenden erlebten in zwei aufeinanderfolgenden Wochen beide Bedingungen, einmal eine nach allen Regeln der Kunst gestaltete aktivierende Präsenzstunde, einmal eine Lerneinheit mit einem eigens entwickelten KI-Tutor. Die Studierenden lernten mit dem KI-Tutor etwa doppelt so viel, und das in kürzerer Zeit. Sie fühlten sich zudem motivierter und stärker eingebunden. Der Vergleichsmaßstab war dabei nicht der schlechte Frontalunterricht, sondern aktivierendes Lehren, also ein hoher Standard.
Infoposter zur Studie
Vier so eng zugeschnittene Interventionsstudien würden wohl eher Randnotizen bleiben, träfen sie nicht auf den aktuellen KI-Hype und eine hoch angespannte Lage im Bildungssystem. Die in dieser Woche veröffentlichten PISA-2025-Ergebnisse für Deutschland zeigen, dass die Hälfte der Fünfzehnjährigen mindestens wöchentlich KI-Chatbots zum Lernen nutzt, der OECD-Schnitt liegt bei 46 Prozent. Fragt man nicht nach Frequenz, sondern schlicht danach, ob überhaupt genutzt wird, ändert sich das Bild noch deutlicher: Nur 9 Prozent der befragten Jugendlichen geben an, KI nie oder fast nie für Schulaufgaben einzusetzen, umgekehrt gerechnet also rund 91 Prozent zumindest gelegentliche Nutzung, ziemlich genau der Wert, den auch die JIM-Studie 2025 für die 12- bis 19-Jährigen insgesamt findet. So unterschiedlich die Frageformulierungen der einzelnen Jugendstudien im Detail auch ausfallen, in der Größenordnung sind sich PISA und JIM hier einig: KI-Nutzung im schulischen Kontext ist für die meisten Jugendlichen längst Alltag, nicht Ausnahme, und das bei einer Geschwindigkeit der Verbreitung, die selbst innerhalb eines Jahres auffällt, allein die JIM-Zeitreihe zur Grundnutzung steigt von 62 auf 91 Prozent.
Vier Studien mit ganz eigenen Limitierungen
Zwei der vier Arbeiten sind Preprints. Die China-Studie liegt als SSRN-Paper vor, die Tennessee-Studie als NBER Working Paper. Beide haben also kein Peer-Review durchlaufen, was einen erheblichen Vorbehalt darstellt. Working Paper werden auf ihrem Weg zur Publikation regelmäßig korrigiert, in ihren Effektstärken relativiert oder in ihrer Analysestrategie in Frage gestellt. Wer sie zitiert, zitiert einen Zwischenstand – da sollten wir ganz vorsichtig sein. Und weitere Punkte sprechen für Vorsicht:
- Bei der China-Studie von Strömberg, Lei und Wu (2026) kommt hinzu, dass der Zeitpunkt der ersten KI-Nutzung auf Selbstauskunft beruht, dass es sich um einen einzelnen „Landkreis“ handelt und dass die eindrucksvoll wirkenden Standardabweichungen teilweise ein Rechenartefakt der Mittelung über viele Fächer sind. Der Zusammenhang zwischen Hausaufgabenzeit und Klausurleistung, der die zentrale Erklärung stützt, ist zudem (wie so oft) korrelativ und nicht kausal belegt.
- Bei der Tennessee-Studie ist das zentrale Lernergebnis mit einem p-Wert um 0,065 nur knapp signifikant, der Test umfasste vier Fragen, und die Messung erfolgte eine Woche später.
- Die beiden peer-reviewten Arbeiten sind methodisch stärker und dafür in ihrer Reichweite aber noch limitierter:
- Bastani et al. betrifft nur Mathematik, nur vier Sitzungen und nur eine einzige Schule.
- Für Kestin et al. gelten Einschränkungen, die man beim Lesen unbedingt im Hinterkopf haben muss – deshalb ist die Studie hier auch nur als Exkurs / Rückblick aufgrund ihrer teils unkritisch positiven Rezeption mit aufgeführt:
- 194 Harvard-Studierende sind eine hochselektive und ausgesprochen lernmotivierte Gruppe,
- es ging um zwei einzelne Lerneinheiten eines Physikkurses, und
- der Test erfolgte direkt im Anschluss.
- Über Lernleistung nach Wochen oder Monaten sagt die Studie nichts.
- Der eingesetzte Tutor war zudem kein Standard-Chatbot, sondern ein von Fachdidaktikerinnen und Fachdidaktikern aufwendig entwickeltes System mit hinterlegten Denkschritten, Vorgaben zur Gesprächsführung und Sicherungen gegen falsche Auskünfte.
- Und die Bedingungen unterschieden sich nicht nur in der Methode: Die Präsenzstunde fand im Hörsaal statt, die KI-Einheit zu Hause.
Alle vier Studien stellen also enge Ausschnitte dar und keine davon misst wirklich in der Gesamtheit, was uns alle umtreibt oder was sich in der Gesamtschau als Eindruck ergeben könnte: Nämlich was mit Bildungsprozessen über Jahre hinweg passiert, wenn generative KI selbstverständlicher Teil des Alltags von Lernenden ist.
KI-Studien und confirmation bias
Studien wie diese finde ich natürlich nicht zufällig, sondern, weil sie zu meinen subjektiven Eindrücken und Erfahrungen passen und weil sie in meiner Peer-Group (gerade bei LinkedIn) präsentiert und diskutiert werden. Wer seit Jahren über Aufgabenkultur und Eigenständigkeit schreibt, für den ist eine Studie mit dem Titel „The Generative AI Learning Penalty“ ein passender Mosaikstein: Die Ergebnisse bestätigen (jetzt endlich auch evident!), was man im Unterricht zu beobachten glaubt (confirmation bias).
Und wer auf Basis dieser Studien direkt mit der Negativ-Interpretation à la „KI schadet dem Lernen!“ beginnt, bedenkt nicht: Auch die Bastani-Studie ist zur Hälfte ein eigentlich positiver Befund, was in der öffentlichen Rezeption regelmäßig untergeht. Denn der KI-Tutor mit Leitplanken hat die Übungsleistung am stärksten gesteigert, ohne dabei dem Lernen zu schaden. Der Titel enthält nicht ohne Grund die in meinen Augen ganz wichtige Einschränkung „Without Guardrails“. Dass Kestin et al. hier trotz der klaren Limitierungen mit dabei sind, ist mir aus eben diesem Grund wichtig, denn ohne diese Arbeit ließe sich aus den anderen drei eine (Negativ-)Erzählung stricken, die so nicht begründet ist.
Dazu kommt ein Publikationsmechanismus, der in beide Richtungen wirkt. Aufsehenerregende Negativbefunde werden derzeit sehr schnell und sehr breit geteilt, gerade in einem Bildungsdiskurs, der Bestätigung für seine Skepsis sucht (denken wir nur an „Your Brain on ChatGPT“). Zugleich hat die Ed-Tech-Branche jahrelang jede kleine positive Effektstärke zum Durchbruch erklärt, und die Harvard-Studie wird genau dafür seit einiger Zeit verwendet, meist ohne die genannten Einschränkungen zumindest zu erwähnen.
Was sich trotzdem als „Konturen“ abzuzeichnen beginnt
Warum dann überhaupt dieser Beitrag? Einmal, weil ich gemeinsam mit Joscha Falck einen Beitrag für das FelloFish-KI-Forum vorbereite und wir diese Studien und ihre Implikationen in den Blick nehmen wollen. Und weil ich sehr dafür plädiere, im Bildungsdiskurs zwischen „Evidenz“ und „Kontur“ zu unterscheiden. An diesen vier Studien finde ich spannend, dass sie aus völlig unterschiedlichen Settings, mit unterschiedlichen Methoden und unterschiedlichen Erkenntnisinteressen in unterschiedlichen Ländern auf ähnliche Muster stoßen, die dann auch noch ziemlich genau dem entsprechen, was viele von uns im Unterricht ohnehin beobachten. Diese Kombination aus schwacher Einzelevidenz und starker Alltagsresonanz bietet keine Gewissheit, aber erste Anhaltspunkte. Konturen eben, die sich abzuzeichnen beginnen.
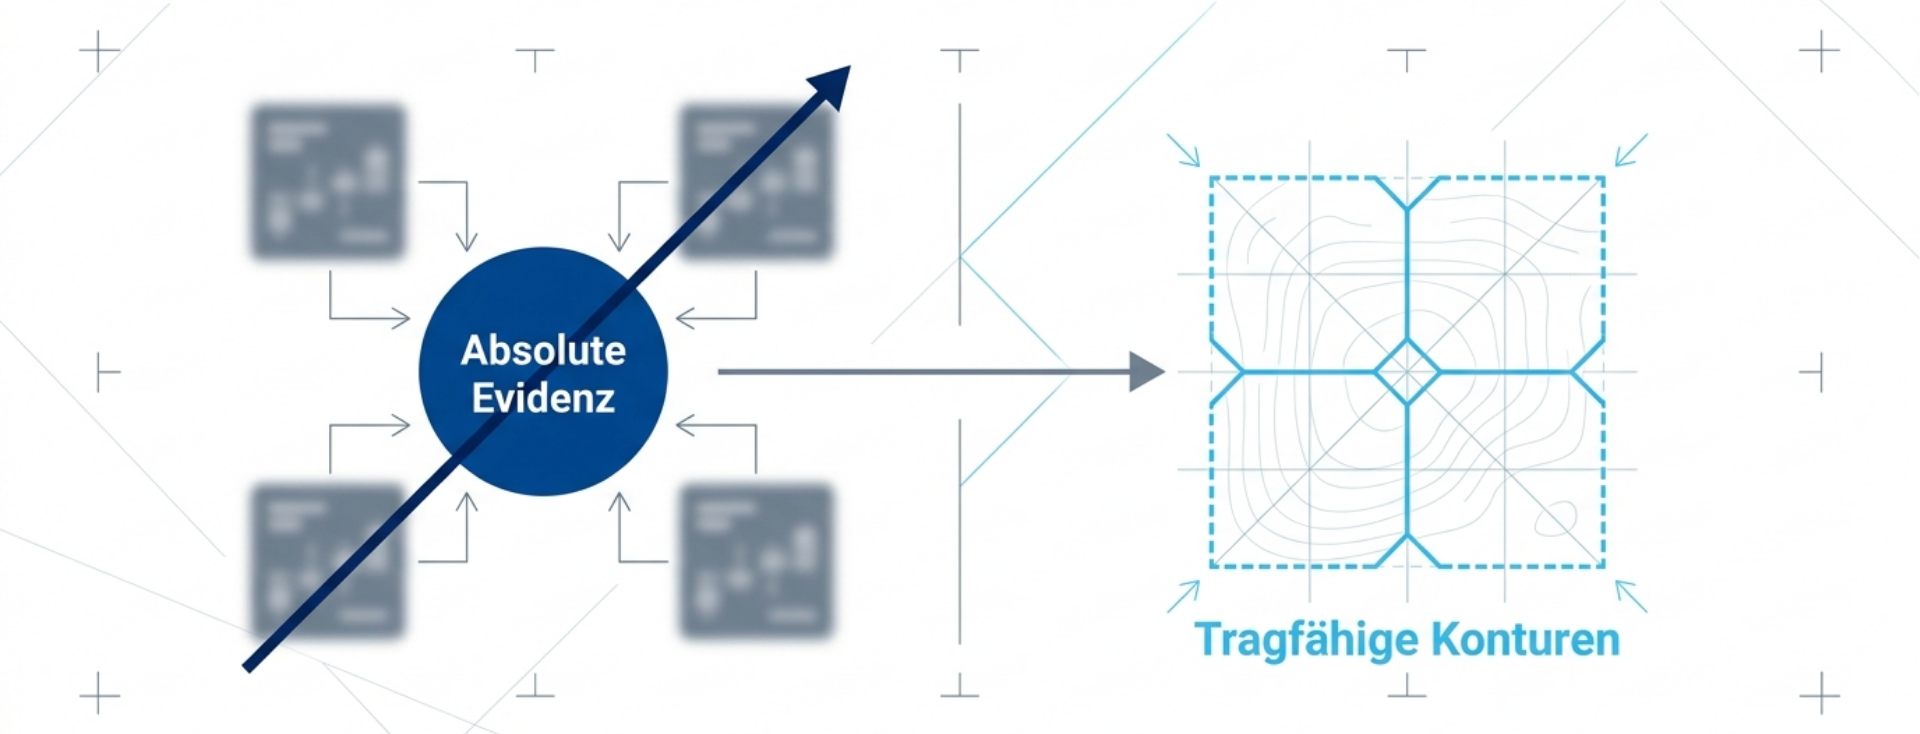
Für mich zeichnen sich momentan mit Blick auf Lernen und KI drei Konturen aus diesen Studien ab:
Kontur 1: Sichtbarer Fortschritt und tatsächliches Lernen entkoppeln sich
In den ersten drei Studien steigt jeweils ein Wert, der im Schulalltag als Erfolg gilt, während der eigentliche Lernstand stagniert oder fällt. In China ist es die Hausaufgabennote, bei Bastani die Übungsleistung, in Tennessee die Erfolgsserie (bemerkenswert ist dabei, dass die Mastery-Regel gar keine KI-Intervention ist). Das Auseinanderfallen von Fortschrittsanzeige und Lernstand ist also kein KI-Problem, sondern ein älteres didaktisches Problem, das durch KI nur sehr viel schneller und sehr viel schwieriger zu trennen wird. Bei Kestin fielen Erleben und Ertrag dagegen zusammen, die Studierenden fühlten sich mit KI-Tutor motivierter und lernten anscheinend mehr. Dass diese Entkopplung kein Ergebnis kleiner Stichproben ist, bestätigt sich in der PISA-Erhebung auf einer ganz anderen Ebene: Wer KI nie oder fast nie für konkrete Schulaufgaben nutzt, schneidet im Mittel am besten ab, während diejenigen, die KI wöchentlich für allgemeine Zwecke einsetzen, ähnliche Ergebnisse erzielen wie Nichtnutzende. Die OECD selbst beschreibt diesen Zusammenhang als komplex, und das trifft den Stand der Dinge ziemlich gut: Es ist nicht die Nutzung an sich, die über den Lernerfolg entscheidet, sondern was dabei getan wird, und daran ändert eine Stichprobe von 700.000 Jugendlichen gegenüber einer Stichprobe von 26.811 wie in China erstmal wenig.
Für die Praxis heißt das vor allem: Jede Rückmeldung, die auf einem Produkt beruht, das außerhalb unserer Wahrnehmung entstanden ist, verliert an diagnostischem Wert.
Kontur 2: Nicht das Sprachmodell oder Tool entscheidet, sondern die Gestaltung der Nutzung
Bastani zeigt Lern-Unterschiede innerhalb desselben Modells, Kestin zeigt, was passieren kann, wenn dieselbe Technologie konsequent nach fachdidaktischen Prinzipien konzipiert wird. Die China-Studie dagegen kommt aus einer anderen Richtung zum selben Ergebnis: Lernende, die trotz KI-Nutzung ähnlich viel Zeit in ihre Hausaufgaben investierten, hatten kaum Lernverluste.
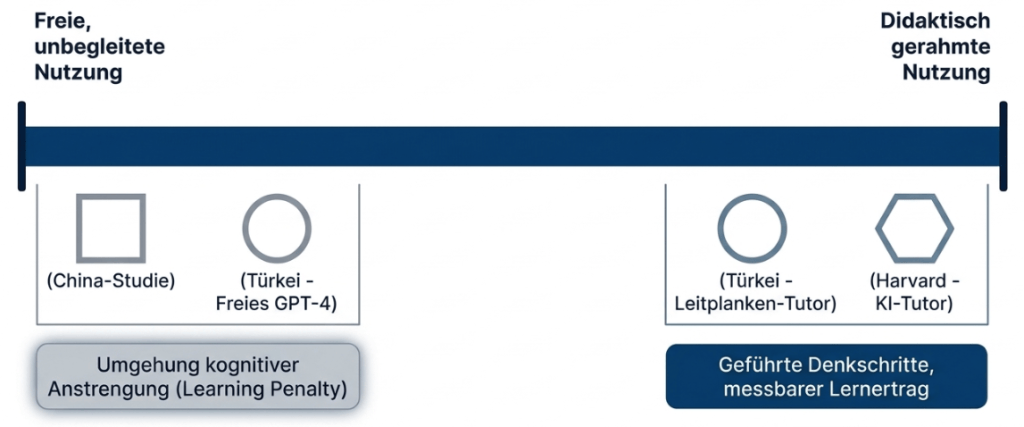
Ich habe hier im Blog schon mehrfach mit dem Angebots-Nutzungs-Modell argumentiert, weil ein Großteil unserer Debatte auf der Angebotsseite stehenzubleiben scheint. Diese Befunde verschieben den Blick aber in die mindestens genauso wichtige Richtung, nämlich auf die Nutzungsseite. Und sie zeigen zugleich, dass die Angebotsseite dabei nicht verschwindet: Der Kestin-Tutor ist ein Angebot, das die Nutzung von vornherein in eine bestimmte Richtung lenkt.
Kontur 3: KI verstärkt die vorhandene pädagogische Ausrichtung (Verstärker-These)
In der Tennessee-Studie zeigte der KI-Tutor allein kaum Wirkung, erst eingebettet in eine Struktur, in der Fehler Konsequenzen haben (Mastery-Regel), entstand ein Effekt. Umgekehrt entfaltet freier Zugang ohne jede Rahmung sein Schadenspotenzial genau dort, wo ohnehin ergebnisorientiert und nicht prozessorientiert gearbeitet wird (Stichwort: „Skill-Skipping“ und „Deskilling“). Kestin ist dann eher der Beleg aus entgegengesetzter Perspektive: Dort stand hinter der Plattform ein Team, das seine Fachdidaktik bereits sehr genau durchdacht hatte, und die KI dafür gezielt nutzte. Jöran Muuß-Merholz‘ Formel vom „großen Verstärker“, die ich in meinem Beitrag zur Renaissance des Menschlichen aufgegriffen habe, findet hier eine empirische Entsprechung. Eine Schule, die Lernen bereits auf Produktabgabe reduziert hat, wird mit KI vor allem effizienter reduzieren.
Eine vierte Beobachtung will ich vorsichtiger formulieren, weil sie stärker interpretiert als belegt ist: Auffällig ist, wer in diesen Studien jeweils die Gestaltungsarbeit leistet. Bei Kestin und beim Bastani-Tutor waren es Lehrende und Fachdidaktikerinnen und Fachdidaktiker, die die Leitplanken vorab eingebaut haben. In der China-Studie wurden die Lernenden dagegen mit allgemein verfügbaren Tools allein gelassen. Der Unterschied im Ergebnis scheint mir doch ziemlich genau mit diesem Unterschied zusammenzufallen.
Das spricht dafür, die Verantwortung für gute KI-Nutzung in diesem Kontext zunächst bei uns als Lehrpersonen zu verorten und nicht bei den Lernenden. Auch das lässt sich an der aktuellen PISA-Erhebung ablesen, nur eine Ebene höher: Etwas bessere Leistungen zeigen sich dort, wo häufige KI-Nutzung mit Gelegenheiten einhergeht, KI-Kompetenzen systematisch aufzubauen. Solche Gelegenheiten kommen aber überproportional sozioökonomisch begünstigten Jugendlichen zugute, wie die OECD selbst anmerkt, mit der Folge, dass sich die KI-Kluft eher vergrößern als schließen könnte. Wenn die Gestaltungsarbeit ausbleibt, wird sie sich also wohl eher entlang bestehender Ungleichheiten verteilen und diese im schlimmsten Fall sogar verstärken („AI Divide“).
Was das für Unterricht und Schulentwicklung bedeutet
Die naheliegende Konsequenz aus einem Befund wie dem der China-Studie wäre, Hausaufgaben abzuschaffen oder KI zu verbieten. Beides halte ich in seiner Absolutheit für falsch, und zwar nicht aus Prinzip, sondern weil die Studien selbst diese Schlussfolgerung gar nicht hergeben. Spätestens mit der Harvard-Studie ist die Verbotsposition auch empirisch schwer zu halten.
Aus meiner Sicht folgen daraus fünf Ansatzpunkte, die ich kürzlich auch schonmal bei Instagram versucht hatte herauszuarbeiten:
Übungszeit schützen, statt Tools zu verbieten
Der gemeinsame Nenner der kritischen Befunde ist nicht, dass KI per se schlecht ist, sondern dass die kognitive Anstrengung, die Lernen erzeugt, umgangen wird. Bei Kestin wurde diese Anstrengung nicht umgangen, sondern gezielt herbeigeführt, nur eben effizienter. Anstrengung braucht Zeit und einen Ort. Wenn das z.B. die Hausaufgabe in ihrer üblichen Form nicht mehr zuverlässig sein kann, muss diese Phase im Unterricht liegen oder muss eine Übungsaufgabe anders gestaltet werden (Darstellung / Aufgabe / Rahmenbedingungen – siehe Manuel Flicks hilfreicher Vorschlag).
Den Prozess sichtbar machen, nicht nur das Produkt bewerten
Das ist keine neue Forderung, aber sie wird durch diese Befunde natürlich verstärkt. Im gemeinsam Gerold Brägger und Joscha Falck entwickelten Modell zum eigenständigen Schreiben unter KI-Bedingungen haben wir versucht zu beschreiben, wie das konkret aussehen kann, wenn jede Phase mit eigenständiger Arbeit beginnt und KI subsidiär mitgedacht wird. Dieser Grundgedanke lässt sich auf viele Fächer übertragen.
Prompts und Tools als didaktisches Material behandeln
Wenn der Unterschied zwischen „learning penalty“ und deutlichem Lernertrag in der Gestaltung der KI-Interaktion im Lernprozess liegt, dann ist ein Prompt oder ein eingeführtes Tutor-/Feedbacksystem eben kein technisches Detail, sondern Lernmaterial. Für Fachschaften könnte das im Sinne professionellen Lernens z.B. heißen: gemeinsam entwickeln, teilen, überarbeiten, ähnlich wie bei Aufgaben oder Klausurentwürfen. Eine einzelne Lehrkraft wird kein System konzipieren wie das Harvard-Team, eine Fachschaft kann aber sehr wohl eine brauchbare Fassung für ein wiederkehrendes Thema erarbeiten und diese dann gemeinsam mit den Lernenden weiterentwickeln (was auch Werkstatt-Projekte an zahlreichen Schulen zeigen).
Aufklärung: Über die Kosten der Abkürzung („learning penalty“) sprechen
Die Studien legen nahe, dass Lernende den Zusammenhang zwischen leichter Bearbeitung und schwächerem Lernen selbst (zunächst) nicht herstellen. Das lässt sich thematisieren, und zwar nicht als Ermahnung, sondern als gemeinsame Auswertung. Eine Klausur ohne KI nach einer Übungsphase mit KI ist dafür ein brauchbarer Anlass, wenn man den Vergleich anschließend auch bespricht. Zudem gilt unverändert mein Plädoyer und ganz praktischer Versuch, in wirklich jeder Unterrichtsstunde in irgendeiner Form über und ggf. auch mit KI zu arbeiten und zu sprechen.
Unsere Erfolgsanzeigen selbst prüfen
Der Tennessee-Befund rückt auch eine Perspektive in den Blick, die wir selten berücksichtigen, nämlich die Erfolgs-Metriken, die unsere Lernplattformen, Materialien, aber auch unsere Bewertungssysteme im Unterricht ausgeben. Wenn eine Erfolgsserie im Lern-System (Kahoot sei als extremstes Beispiel genannt) wenig bis nichts über den Lernstand aussagt, ist das System nicht neutral, sondern irreführend, für Lernende wie für uns. Ähnliches gilt inzwischen wohl auch für die „sonstige Mitarbeit“, wenn sie unverändert ausschließlich die „mündliche Leistung“ umfasst.
Auf der Ebene der Schulentwicklung heißt das wohl vor allem, den Diskurs nicht auf der Tool-Ebene zu führen. Wie wichtig hier das Zusammenwirken als Schulgemeinschaft ist, zeigt auch ein Blick ins Lehrerzimmer: Während annähernd jede zweite Schülerin und jeder zweite Schüler KI inzwischen wöchentlich zum Lernen nutzt, geben im Deutschen Schulbarometer erst 19 Prozent der Lehrkräfte an, KI mehrmals wöchentlich beruflich einzusetzen, ein Anteil, der sich gegenüber dem Vorjahreswert von 9 Prozent zwar mehr als verdoppelt hat, die Kompetenzlücke zwischen Klassenraum und Lehrerzimmer damit aber eher sichtbar macht als schließt. Ich habe an anderer Stelle beschrieben, warum Fortbildung und Schulentwicklung zusammengehören und warum Impulse ohne strukturelle Verankerung verpuffen.
Die vier Studien liefern dafür ein zusätzliches Argument, weil keine der ableitbaren Konsequenzen sich in einer Tool-Schulung unterbringen lässt. Sie betreffen Aufgabenkultur (Stichwort: „guardrails“ bei Bastani), Prüfungskultur und die Frage, worüber wir mit Lernenden eigentlich in welcher Form sprechen. Wer hier ansetzen will, braucht eben keine neuen Plattformen, sondern ein gemeinsames Verständnis darüber, wo im Lernprozess eigenständige Denk-/Übungs- und damit Lernzeit stattfindet und wie sich diese schützen und unterstützen lässt.
Für den Einstieg in einen solchen Prozess mit Schülerinnen und Schülern habe ich basierend auf der Arbeit von Manuel Flick ein Konzept in sechs Schritten als Projekttag skizziert, für die Fachschaftsarbeit wird hier in Kürze ein Prozessvorschlag folgen und mit Blick auf systematischen Aufgaben-Remix sind aus einer aktuellen Fortbildung neue Ideen entstanden…bald mehr dazu…
Fazit
Vier Studien sind keine Evidenzlage. Zwei davon sind Preprints, alle vier sind schmale Ausschnitte aus sehr spezifischen Kontexten. Wer sie als Beleg dafür nimmt, dass KI per se dem Lernen schadet, liest sie falsch – und wer meint, aus der Harvard-Studie ablesen zu müssen, dass KI „das Lernen verdoppelt“, liest diese Studie nicht weniger falsch.
Sehr wohl bleiben aber sich abzeichnende Konturen – auch wenn alle Poster nebeneinander hängen: Sichtbarer Fortschritt und tatsächliches Lernen fallen unter KI-Bedingungen leichter auseinander als zuvor. Die Gestaltung der Nutzung entscheidet stärker über den Ertrag als das Tool an sich, und diese Gestaltungsarbeit liegt momentan in erster Linie bei uns Lehrpersonen im Zusammenspiel mit der ganzen Schulgemeinschaft. Diese Konturen sind nicht bewiesen, werden aber mit Blick auf die Studienergebnisse plausibel, und treffen in dieser Woche auf die PISA-Ergebnisse, die dieselbe Grundspannung noch einmal in großem Maßstab bestätigen. Für schulische Entwicklungsarbeit ist das in meinen Augen schon genug, solange wir den Unterschied zwischen Evidenz und Kontur nicht aus den Augen verlieren und verwischen.
Besonders dankbar bin ich dabei Benedikt Wisniewski für seine differenzierten Kurzanalysen zu den drei aktuell relevanten Studien und damit insbesondere für einen momentan besonders wichtigen Aspekt: Rückversicherung, ob wir als „einfache“ Lehrpersonen mit unseren Annahmen wirklich richtig liegen. Ich denke, Benedikts Einschätzungen bestätigen die vorsichtig weiter zu verfolgende Linie, die sich aus den Konturen dieser Studien ergibt: Aufklären, Ausprobieren, Aktiv werden – aber mit klaren Leitplanken.
Mir ist dabei am wichtigsten, dass wir uns die Fähigkeit erhalten, unsere eigenen Annahmen zu prüfen. Das ist im Übrigen genau die Kompetenz, die wir bei unseren Schülerinnen und Schülern im Umgang mit generativer KI ja irgendwie voraussetzen.
Verwendete Quellen
Strömberg, D., Lei, V. & Wu, Y. (2026): The Generative AI Learning Penalty: Evidence from Chinese Secondary Education. SSRN Working Paper 6868618.
Bastani, H., Bastani, O., Sungu, A., Ge, H., Kabakcı, Ö. & Mariman, R. (2025): Generative AI Without Guardrails Can Harm Learning: Evidence from High School Mathematics. PNAS 122(26): e2422633122.
Oreopoulos, P., Liut, M., Sungu, A. & Low, H. (2026): Making AI Tutoring Productive: Evidence from a Mastery-Based Math Practice Experiment. NBER Working Paper 35621.
Kestin, G., Miller, K., Klales, A., Milbourne, T. & Ponti, G. (2025): AI tutoring outperforms in-class active learning: an RCT introducing a novel research-based design in an authentic educational setting. Scientific Reports 15: 17458.
OECD (2026): PISA 2025 Ergebnisse, Band I – Ländernotiz Deutschland.
Medienpädagogischer Forschungsverbund Südwest (2025): JIM-Studie 2025 – Jugend, Information, Medien.
Bitkom e. V. (2025): Digitale Schule 2025.
ifo Institut (2025): ifo Bildungsbarometer 2025.
Vodafone Stiftung Deutschland (2024/2025): Pioniere des Wandels; KI an europäischen Schulen.
Robert Bosch Stiftung / forsa: Deutsches Schulbarometer.
Die Poster zu den Studien stehen unter CC BY-SA 4.0 zum Download bereit und können gerne weitergenutzt und verändert werden.